我们不只是做了一个网站:网站如何帮助构建 DETai 生态系统
这篇文章讲的是我们的网站是如何做出来的。也讲这个过程里技术上的,以及大概也有一部分心理上的东西。
不过现在,经过了足够长的时间之后,越来越能看清:说“我们做了一个网站”,其实并不完全准确。
我们确实是从网站开始的。我们想给 DETai 做一个现代的网站:好看、快、多语言、对人清楚,而且技术上足够扎实,不至于每隔几个月就要从头重做。乍看之下,这是一项相当明确的任务。可越往下做,出现的问题就越不像是在问网站本身。
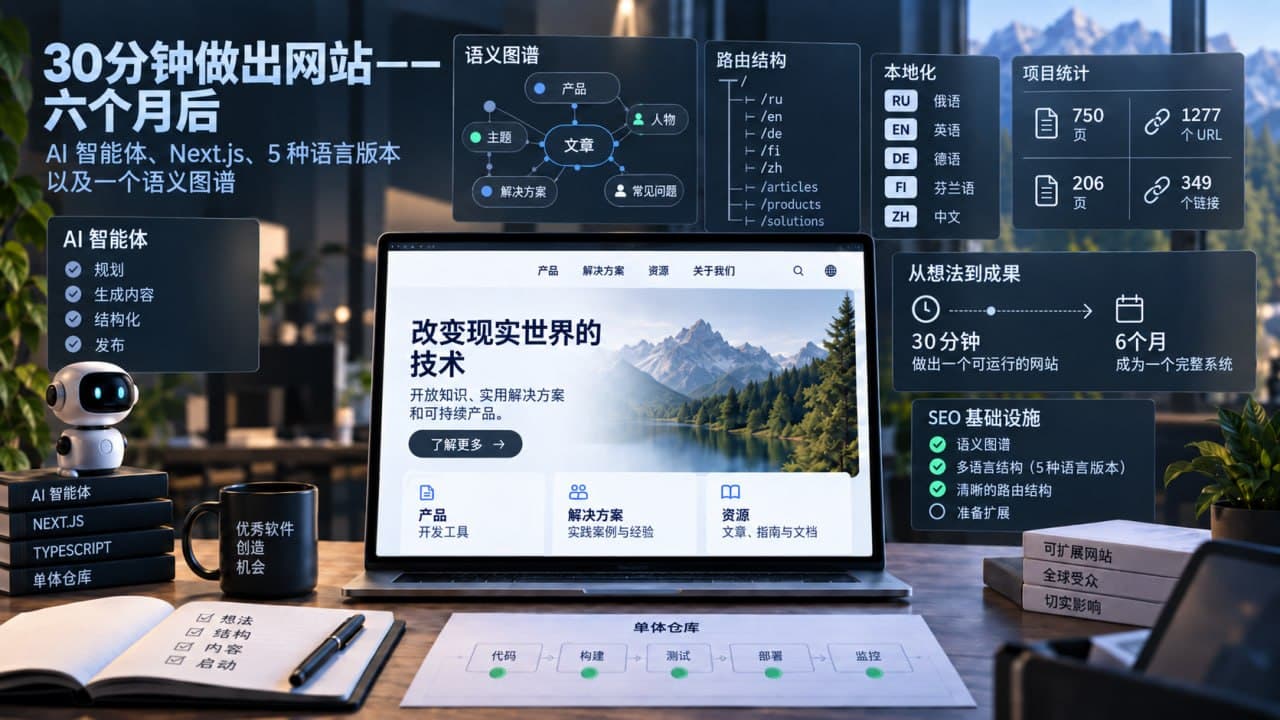
什么属于 DET,什么属于 DETai?一个方向在哪里结束,一个产品又从哪里开始?生态系统的哪些部分应该有自己的页面?研究、教育、心理治疗、产品和技术平台之间是什么关系?哪些信息应该公开,哪些应该留在内部?不同的界面需要哪些法律文件?数据归谁负责?一个定义的规范来源在哪里,它的公开解释又在哪里?接着又加入了本地化、SEO、GEO、图片来源、页面创建和修改日期、人物与组织的身份、实体之间的关系,以及 结构化数据——那个几乎看不见的层,它帮助搜索系统理解:眼前的东西究竟是什么。
这里谁是一个人,什么又是一个组织。什么是出版内容,什么是产品,什么是项目。页面什么时候出现,又是什么时候真正发生了变化。图片从哪里来。一个对象和另一个对象是什么关系。普通访问者几乎不会意识到这些东西的存在:他打开页面,看到文字、图片和按钮,而在这些东西下面,另一个网站正在慢慢长出来——它不是主要给眼睛看的,而更多是给机器理解的。也就是在又一次这样深入工作的第三天左右,我脑子里很自然地冒出了一个问题:如果半年以后,这里面有一半都不再需要了呢? 甚至两周以后就不需要了呢?
Google 会改变建议,AI 搜索会学会用另一种方式理解网站,Schema.org 可能失去一部分现在的重要性,会出现新的标准,或者承载这一切的 framework 会换掉。
在数字环境里,昨天还是 best practice 的东西,明天完全可能变成一段历史注脚。那是不是意味着,前面几天的工作都可以直接扔掉?如果想起整个故事最开始是怎么来的,这个问题尤其好笑。因为我们原本只是想做一个网站。
当网站还只是网站的时候
有一段时间,WordPress 真的几乎像神一样。
现在这么说听起来有点讽刺,但当时完全是认真的。WordPress 让一个没有开发团队的人也能搭出真正的网站:装主题、接插件、做博客、表单、分析,然后打开 Elementor,突然就有一种自己差不多也是网页设计师的感觉。
在它所属的时代,这是一种极其强大的模式:你不需要单独设计 frontend 和 backend,也不用把基础设施看成一组相互作用的系统——你就是在搭一个网站。需要新功能,几乎总能找到插件;想换外观,就有主题或者 visual builder。
我们在这种思维方式里生活了很久,直到慢慢发现,真正需要在工作开始时提出的问题已经变了。
以前的问题是:“我们想做一个什么样的网站?” 而现在更常见的问题变成了:“我们想构建一个什么样的系统——而网站在这个系统里是什么?”
现代 Web 开发变成了组件化,GitHub 成了开发工作的中心,Next.js 把普通网站和应用的一些特性连接到了一起,Vercel 让 deployment 几乎变成代码变化之后自然发生的下一步。但对我们来说,真正的转折发生在 AI 进入这个工作回路之后。以前边界很清楚:要么你自己会编程,要么你就在程序员提前给你划定的能力范围里工作。
AI 让这条边界明显没那么硬了。这并不意味着编程消失了,也不意味着编程突然不需要专业知识。更准确地说,人可以从另一个层面参与工程工作:讨论数据结构、ownership、系统边界、系统之间的接口、具体对象的规范来源,以及架构决策会带来什么后果,而不一定要亲手写每一个函数。工作慢慢变成了这种样子:这份数据不能重复;不同语言版本应该是同一个意义的独立表达;这一层属于网站,这一层属于 Storytelling,那一层属于 Knowledge Substrate;这里需要 provider,那里需要 consumer,两者之间要有一个稳定的 contract。也就是在这里,一切彻底偏离了最初的计划。因为最初的计划非常简单:再给两周,网站就好了。
现在回头看,这句话已经有点像一个历史笑话了 🙂
我们为什么在这件事上花了这么久?
到了某个阶段,我们不得不再问一个问题,而它后来比那些技术问题重要得多:我们为什么不能就停在这里?
为什么不能拿已经很好看的首页、几个栏目、正常的移动端,再接上分析工具,然后说:好了,网站已经存在了?大概是因为我们慢慢开始用完全不同的方式看它。当然,任何一个具体的网站都不可能“永远”存在。设计会变。代码会重写。有些页面会消失。今天看起来很现代的技术,几年以后大概会像现在那种装了四十七个插件的老 WordPress 后台一样——其中最后十二个插件到底干什么的,已经没人记得了。但网站的角色比它当前的实现方式要持久得多。
DETai 的技术栈可能会改变,会出现新的产品、新的人、新的研究和新的工作形式,但生态系统向外部世界呈现自己的那个地方,很可能会长期存在。
网站是整个系统最重要的公共表达之一。
如果从这个角度来看,任务就突然变了。我们不再需要试图做一个永远不用修改的网站——这根本不可能。真正要做的是搭出一种基础,使它能够长期随着生态系统一起变化,同时又不失去自己的身份。
Stewart Brand 在 How Buildings Learn: What Happens After They're Built 里有一句话特别贴合这件事:
“建筑不是你完成的东西。建筑是你开始的东西。”
(Stewart Brand,How Buildings Learn: What Happens After They're Built,1994;译自英文)
Brand 写的是建筑如何在建筑师认为工作已经结束以后继续生活:人们会改变它、改造它、让它适应新的环境,而它能不能承受这些变化,很大程度上决定了原始架构的质量。某个时候我突然意识到,网站正在发生几乎同样的事情。我们并不是在做一个未来某天可以郑重宣布“已经完成”的页面。
我们是在启动一个长期存在的数字结构,而这个结构里的几乎一切,未来都还会变很多次。
当网站逼着你回答所有问题
而这里发生了可能最意外的一件事:网站不再只是展示 DETai——它开始逼着我们定义 DETai。
只要生态系统还存在于谈话、零散文档、repository 和每个人脑中的理解里,很多边界都可以长期保持一点模糊。大家大概知道彼此在说什么。但试着把这一切真正拆成页面看看。
顶部导航应该放什么?什么值得拥有独立页面,什么其实属于另一个实体?如果页面写着“DETai 产品”,我们究竟把什么叫作产品?如果研究有独立栏目,研究活动、方法和技术平台之间的边界到底在哪里?如果一个项目有自己的用户数据,这些数据属于整个生态系统,还是属于某一个具体产品?如果一个人打开法律文件,它究竟属于哪个界面?如果同一个想法同时存在于 Knowledge Substrate、某篇出版内容和网站里,那么它的规范定义在哪里,面向特定受众的版本又在哪里?
到某个时候我们发现,做网站导航这件事几乎在不知不觉中变成了处理生态系统本身的本体结构。我们不得不真的决定:它由哪些对象构成,这些对象之间是什么关系。于是设计意外地牵出了架构,而公共用户路径又牵出了法律文件和数据处理规则。
而且,为了能用简单语言把这一切解释给人听,我们又一次次被迫回到架构里,问自己:我们自己真的理解这里到底建了什么吗?
于是形成了一个很有意思的循环:我们试图通过网站描述生态系统,而想把网站做好这件事,又迫使我们越来越准确地描述生态系统本身。最后,网站变得有点像 DETai 的集成测试。如果系统里的两个部分无法在公共页面上清楚地连起来,问题也许并不在页面。如果我们解释不清两个实体的区别,也许是我们自己还没有把它们的边界定义得足够清楚。如果不知道数据归谁,或者一个定义究竟应该从哪里来,那么再漂亮的 UI 也解决不了问题。大概也正因为这样,几个月围绕“网站”的工作,最终包含了设计、编程、语义、SEO、法律架构、本地化,以及对 DETai 模型本身的整理:一个公共界面突然要求它背后的整个系统都必须足够明确。
一个不再只是网站的网站
网站本身当然没有消失。恰恰相反,它慢慢变成了 DETai 最重要的公共界面之一。通过它,人可以进入方法、研究、教育、产品、团队、活动、出版内容和文档。这一角色现在也已经明确写在 Knowledge Substrate 的“DETai 网站”项目页面里:网站是生态系统的公共 Web 层,用来解释它的结构、展示关系,并把人引向产品、知识和参与方式。
也正因为如此,它越来越不像一个用来堆放“已经做好的内容”的容器。拿一篇普通的出版内容来说,它可能从一个想法或者一条语音笔记开始,然后变成文字,经过编辑,获得图片、元数据、语言版本和面向不同渠道的多种 representation,最后才出现在网站或者 Telegram 上。于是,网站不再是对象出生的地方,也不再拥有对象的整个生命周期;它只是对象存在的一种形式。
所以,网站旁边慢慢长出了 Storytelling——一个独立的 Publication Core,负责出版内容的准备和流转;Knowledge Substrate 保留稳定定义、架构边界、ownership、policies 和版本;不同产品保留自己的逻辑和数据;而网站把这一整套结构组织成一个对人来说连贯的公共形象。
也许正是在这里,出现了我目前最喜欢的一种说法:网站慢慢变成了一套数字呈现体系。DETai 对一个人、一个搜索系统或者一个 AI 智能体来说,不应该只是一组随机相连的 URL,而应该是一套可辨认的结构,让人能够理解:这是什么、为什么存在,以及它和其他部分是什么关系。
而新的讽刺也从这里开始:架构越清楚,你就越能看见里面还有多少可以继续改进的地方。
一个没有“完成”状态的项目
复杂系统有一个挺让人不舒服的特点:在它几乎还不存在的时候,看起来总是特别简单。只要你手里还只有“未来要做一个网站”这个想法,任务似乎就有明确终点——把页面做出来,结束。等页面真的出现以后,一层又一层的东西也跟着出现。**“完成”**这个状态好像总是在往前退几步。
你可以把它理解成一个永远结束不了、但又很美好的无穷项目 😅 也可以在某个时候意识到另一件事:也许真正错误的,是我们一开始就把“最终完成”当成了目标。
于是我们又回到了最开始的问题:如果今天做的大量工作以后反正都会过时,那这些投入是不是都白费了?
不知道为什么,我总会想到一个很简单的训练类比。
一个人长期训练,结果看起来很具体:肌肉、力量、体型。但所有人都知道,只要停得够久,相当一部分结果就会开始消失。那也可以问:既然这些效果不会永久保留,之前那些组数、那些训练到底有什么意义?
答案之所以显得很明显,是因为训练的结果从来不只是肌肉。与此同时形成的,还有承受负荷的能力、停一段时间之后重新回来、维持节奏、在并不特别想做的时候再完成一组,以及不必每次都依赖“灵感”的能力。哪怕某种具体状态消失了,一个曾经学会如何把它建立起来的人,也已经和那个还只是准备开始的人有一点不同。
技术似乎也是这样。某段具体代码可以扔掉,framework 可以换掉,deployment 可以重写,数据模型可以完全改变,有一天甚至可以把整个网站从零重建——但理解一个陌生系统、看见关系、承受复杂性并把它推进到可工作状态的能力,不会随着 repository 一起被删掉。
就在不久以前,很多今天已经几乎变成日常工作的事情,还在我们熟悉语言的边界之外。并不是因为我们制定了一个精巧计划,想再学会五种职业,而是因为项目的每一层都要求比上一层多理解一点。然后在某个时候,会发生一个很好笑的反转:一开始你害怕打开代码,担心不小心弄坏什么;后来你开始害怕碰架构;再过一阵,情况完全反了过来——当你已经看见旧方案不再适合系统时,有时候更可怕的是不去改它。
也许这是 DETai 工作里最重要的结果之一,而这个结果在网站上完全看不见。
网站上看不见的东西
到了那第三天晚上,我的大脑已经完全不想再看 JSON-LD、canonical、provenance、日期、标识符以及实体之间的关系。一个完整工作日之后只剩下很普通的身体疲劳。然后在骑车回去的路上,突然出现了一种意外平静的感觉:今天有些东西变得更好了。
不是永远——而这大概是这里最重要的一句补充。
慢慢地,那种“工作的意义一定是做出某个以后再也不需要改变的东西”的想法正在消失。网站会变,公司会变,职业会变,身体会变,技术会变,而那个做这一切的人自己也会变。
奇怪的是,稳定并不是在系统停止变化时出现,而是在系统获得一种能力之后出现:它可以变化,却不必失去自己。
对 DETai 来说,这甚至形成了一个很自然的悖论。我们围绕人的实践构建技术生态系统,同时又不希望技术取代实践本身;我们设置相当严格的架构边界,恰恰是为了让系统以后可以更自由地发展;我们把规范知识固定在 Knowledge Substrate 里,却允许出版内容保留成为某一个具体时刻的“活的快照”的权利;我们用 AI 加快速度,同时也越来越清楚地意识到,人对意义承担责任这件事有多重要。
所以最后,网站的故事似乎并不主要是在讲 Next.js、Vercel、GitHub、Schema.org 或 AI。所有这些技术都很重要,但每一种都只是属于某一个时代的工具。
真正有意思的事情发生在另一个层面。
我们从想做一个网站开始,慢慢学会了思考一个系统。我们从单独的页面开始,最后走到了对象之间的关系。我们最初问的是**“人会看到什么?”,现在同时也在问“机器会理解什么?”。我们本来只是想把一个已经存在的生态系统展示出来,却在这个过程中发现:恰恰是“必须把它展示出来”这件事,逼着我们更准确地理解它到底由什么构成**。
因此,一开始那个问题——“如果这一切有一天全都白做了呢?”——现在听起来已经不太一样了。
具体的结果确实可能消失。代码可以重写,标准可以替换,技术可以被遗忘,网站可以完全重建——而且很可能有一天它真的就会经历这些。但如果 Stewart Brand 是对的,建筑不是你完成的东西,而是你开始的东西,那么也许数字系统也应该被这样对待:不是去猜它们最终会长成什么样,而是把它们建成一种能够活过自己最初架构的东西。
也许正因为如此,在一个非常疲惫的工作日结束时,有时会出现一种奇怪而又挺舒服的感觉:几乎没力气了,脑子也累了,明天一切还会继续——但心里却是好的。
因为有一种疲劳来自没有意义的运动。还有另一种完全不同的疲劳——它来自这样一个事实:今天的你,已经能够完成一件比昨天稍微更复杂的事。
也许也正是在这种时候,一个很简单的想法会变得特别清楚:
生活,就是你很高兴自己累了。
来源与材料
-
Brand, Stewart. How Buildings Learn: What Happens After They're Built. Viking Press,1994。一本把建筑理解为持续变化系统的书;其中引用了“A building is not something you finish. A building is something you start”这句话。
https://www.penguinrandomhouse.com/books/320919/how-buildings-learn-by-stewart-brand/ -
Google Search Central — Introduction to structured data markup in Google Search. 介绍结构化数据如何向搜索系统明确传递页面内容的意义和类型。
https://developers.google.com/search/docs/appearance/structured-data/intro-structured-data -
Schema.org. 面向 Web 结构化数据的开放类型、属性和关系词汇表。
https://schema.org/ -
DETai Knowledge Substrate — “DETai 网站”。 关于网站作为生态系统公共 Web 层的规范说明,包括它的边界,以及它与产品、知识和 Storytelling 的关系。
https://docs.detai-x.com/ru/ecosystem/DETai/Platform_DETai/E2-Brand/sites/ -
DETai Knowledge Substrate — “Storytelling — Publication Core”。 关于 DETai 发布层以及内容准备与渠道分发之间责任划分的规范说明。
https://docs.detai-x.com/ru/ecosystem/STORYTELLING/
文章主题问答
01如果做几个页面就够了,为什么 DETai 还需要这么复杂的网站?
因为这个网站逐渐不再只是一个展示窗口,而是成为了整个生态系统的公共架构。为了清楚地呈现 DETai,我们必须明确各个方向、产品、研究、出版内容、知识、数据和法律边界之间的关系,并让这套结构不仅对人,也对搜索系统和 AI 系统可理解。
02网站如何帮助人理解 DETai 生态系统由什么构成?
当我们试图把 DETai 拆解并呈现在不同页面上时,就必须准确界定各部分之间的边界:什么是方向、产品、研究或出版内容,规范知识源在哪里,数据由谁负责。于是,网站本身就成了整个生态系统的一种集成测试。
03DETai 网站如何让搜索引擎和 AI 更容易理解?
除了可见页面之外,网站还使用本地化、结构化数据、实体身份及其关系、日期、媒体来源信息和规范来源。这个机器可读层帮助搜索系统和 AI 系统区分人物与组织、出版内容与产品,并理解 DETai 各部分之间的关系。